Лучшие ИИ-модели для пресс-служб: 330 прогонов через Пресс-Офис
Одиннадцать моделей писали один и тот же релиз по 30 раз. Факты передали все, а разница нашлась в стабильности, скорости и цене.
Коротко
- Все 11 моделей в 330 прогонах передали все факты и не выдумали ни одного числа: с хорошим промптом точность больше не различает модели.
- Идеальный балл языка на всех 30 прогонах только у YandexGPT rc и Qwen 3.8 Max.
- YandexGPT отвечает за 2,5 секунды, Qwen рассуждает почти 5 минут: разрыв в 118 раз при одинаковом результате.
Задача для всех фронтир-моделей была одна: пресс-релиз ведомства объёмом до 800 знаков по фактуре об открытии центров поддержки экспортёров. Фактура специально насыщена проверяемыми данными: пять регионов поименно, две даты запуска, план в обращениях и сделках, бюджет, имя куратора, цифра прошлого года, срок выхода на рынок.
Всего взяли 11 моделей: Claude Opus 5 (Anthropic), GPT-5.6 Sol (OpenAI), Gemini 3.7 Flash (Google), Grok 4.6 (xAI), Qwen 3.8 Max (Alibaba), Kimi K3 (Moonshot), DeepSeek V4 Pro, GLM 5.2 (Zhipu), Seed 2.1 Turbo (ByteDance), Mistral Medium 3.5 и YandexGPT rc (yagpt-5.1). Все они передали 6 ключевых фактов и все 13 фактов источника, не выдумали ни одного числа и получили максимальный балл по верности источнику.
Модели «перестали выдумывать» не просто так: работал расширенный системный промпт Пресс-Офиса на хорошо поставленной задаче. Поэтому выбирать модель только по точности данных сегодня бессмысленно. Проще говоря, с хорошим промптом любая модель хороша.
Больше внимания хочу уделить другим показателям, но сначала подробнее опишу условия тестирования.
Условия
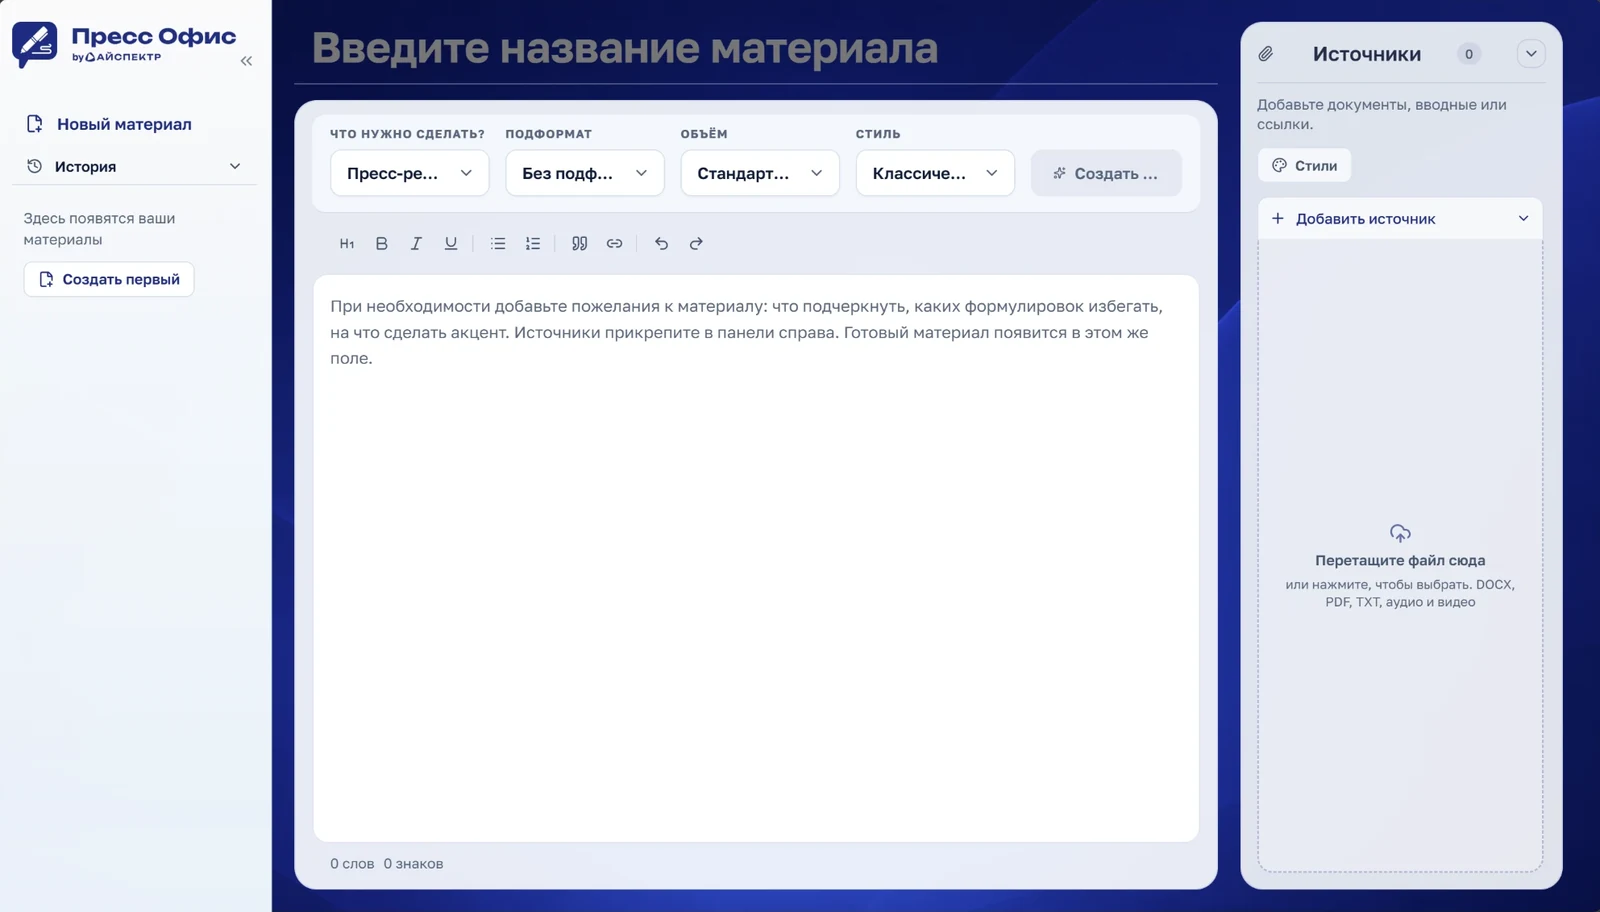
- Промпт тот же, которым Пресс-Офис пишет релизы в проде: 11,5 тыс. знаков, специально построен против нейрослопа.
- Температура 0,5, производственное значение.
- Разбор источника выполнен один раз и заморожен: все модели получили один и тот же.
- По 30 прогонов на модель. Этого хватает на 95%-ные доверительные интервалы и парные тесты значимости.
Бюджет: 16 долларов за 330 генераций. Всё сравнение фронтир-моделей обошлось дешевле одной бизнес-подписки.
Показатели
Основных показателей три.
- Языковая норма, от 0 до 10
- Балл за отсутствие нейрослопа на самописном чекере на базе Vale. Он ловит пустые зачины, ложные антитезы («не просто X, а Y»), фантомные ссылки («эксперты отмечают»), канцелярит, страдательный залог, предложения длиннее 35 слов, механическую симметрию абзацев, тройки без трёх фактов и злоупотребление тире. Оценка нормируется на объём текста.
- Фактура
- Ядро из 6 фактов, без которых релиз не работает, полнота по всем 13 фактам источника и выдуманные числа.
- Верность источнику, от 0 до 1
- Метрика FaithfulnessMetric из deepeval: текст разбирается на утверждения, и каждое сверяется с фактурой.
Результаты
Все 330 прогонов из 330 передали все 6 ключевых фактов и все 13 фактов источника, не выдумали ни одного числа и получили 1,00 по верности. Ни одного расхождения на 330 попытках. Правила против нейрослопа применялись в каждом запросе.
| YandexGPT rc | 10,00 | ±0,00 | 0,0 | 30 | 2,5 |
|---|---|---|---|---|---|
| Qwen 3.8 Max | 10,00 | ±0,00 | 0,0 | 30 | 295,9 |
| Grok 4.6 | 9,90 | ±0,03 | 0,2 | 8 | 126,5 |
| Gemini 3.7 Flash | 9,85 | ±0,11 | 1,2 | 14 | 11,1 |
| Claude Opus 5 | 9,79 | ±0,06 | 0,7 | 4 | 27,2 |
| Kimi K3 | 9,76 | ±0,07 | 0,8 | 3 | 199,5 |
| Seed 2.1 Turbo | 9,70 | ±0,00 | 0,0 | 0 | 111,8 |
| DeepSeek V4 Pro | 9,61 | ±0,04 | 0,4 | 0 | 133,6 |
| GPT-5.6 Sol | 9,60 | ±0,00 | 0,0 | 0 | 16,3 |
| GLM 5.2 | 9,58 | ±0,08 | 0,9 | 0 | 9,3 |
| Mistral Medium 3.5 | 9,40 | ±0,08 | 0,9 | 0 | 11,5 |
Ядро 6 из 6, полнота 13 из 13, ноль выдуманных чисел и верность 1,00 у всех одиннадцати моделей, поэтому в таблице только то, что различается. Нажмите на заголовок столбца, чтобы отсортировать.
Стабильность выдачи
Здесь результат уже заметнее. Чистый результат на всех 30 прогонах показали только две модели, и это, на удивление, YandexGPT rc и Qwen 3.8 Max. Grok 4.6 на малой выборке тоже показывал медиану 10,0, но на дистанции просел: идеальны только 8 прогонов из 30, среднее 9,90.
- YandexGPT rc30 из 30
- Qwen 3.8 Max30 из 30
- Gemini 3.7 Flash14 из 30
- Grok 4.68 из 30
- Claude Opus 54 из 30
- Kimi K33 из 30
- Seed 2.1 Turbo0 из 30
- DeepSeek V4 Pro0 из 30
- GPT-5.6 Sol0 из 30
- GLM 5.20 из 30
- Mistral Medium 3.50 из 30
Различия между моделями статистически значимы: Friedman χ² = 225,8 при p < 0,001, согласованность рангов Kendall W = 0,75. Даже разница в 0,1 балла между Qwen и Grok значима (p = 0,0002): Qwen стабильно чуть лучше для пресс-релиза, и случайностью это не назовёшь.
Но уточню: разница между 10,00 и 9,90 существует надёжно, а означает одно лишнее срабатывание чекера нейрослопа на несколько релизов. Для пользователя Пресс-Офиса это правка на 10 секунд. А разница между 10,0 и 9,4 уже другое качество текста: такую модель в текущих условиях использовать не рекомендую.
У YandexGPT, Qwen, Seed 2.1 Turbo и GPT-5.6 Sol стандартное отклонение равно нулю: все тридцать прогонов дали один и тот же балл. Seed выдал 9,7 тридцать раз подряд, GPT-5.6 Sol 9,6 тридцать раз подряд.
Время рассуждения
YandexGPT рассуждал 2,5 секунды (медиана 30 прогонов, разброс 2,2–2,9 с). Qwen 3.8 Max рассуждал 295,9 секунды, а в отдельных прогонах до 385.
- YandexGPT rc2,5 с
- GLM 5.29,3 с
- Gemini 3.7 Flash11,1 с
- Mistral Medium 3.511,5 с
- GPT-5.6 Sol16,3 с
- Claude Opus 527,2 с
- Seed 2.1 Turbo111,8 с
- Grok 4.6126,5 с
- DeepSeek V4 Pro133,6 с
- Kimi K3199,5 с
- Qwen 3.8 Max295,9 с
Медиана 30 прогонов, время прохода через прокси вычтено.
Уровень рассуждений я никому отдельно не настраивал: замерял поведение из коробки, как его получил бы обычный пользователь.
Qwen 3.8 Max тратит 61 токен выхода на каждое слово готового релиза и рассуждает в 60 раз больше, чем пишет. YandexGPT тратит 0,8 токена на слово. Разница в расходе почти в 80 раз, хотя база у всех одна. Четыре рассуждающие модели (Kimi K3, Qwen 3.8 Max, Grok 4.6, DeepSeek V4 Pro) потратили 10,29 доллара, около 67% бюджета, за 120 прогонов из 330. И не купили за эти деньги ни одного дополнительного балла: лучшая модель без рассуждений (YandexGPT) идёт вровень с лучшей рассуждающей (Qwen).
Ошибки, не вошедшие в результат
Дефекты формата на дистанции сложились в закономерности.
GLM 5.2 в 20 прогонах из 30 вписал служебные поля (placeholders, warnings, needs_review) в текст релиза, а в 10 применил Markdown вопреки запрету. Чистых прогонов 10 из 30. В проде это служебный мусор в документе пользователя, поэтому эту модель отсекаем. Mistral превысил лимит заголовка в 20 прогонах из 30, Qwen, Kimi и Seed в 10 из 30.
Чаще всего чекер ловил тройки без трёх фактов и злоупотребление тире (51 раз), канцелярит и длинные предложения (48), симметрию абзацев (43).
Вердикт
- Если важнее всего текст
- Qwen 3.8 Max и YandexGPT rc: единственные две модели с нулём языковых нарушений на 30 прогонах каждая. Цена вопроса у Qwen: 296 секунд и 0,121 доллара за релиз. У YandexGPT 2,5 секунды.
- Если пресс-служба работает на потоке
- Gemini 3.7 Flash: среднее 9,85, идеальный формат в 30 прогонах из 30, 11 секунд и 0,0043 доллара за релиз. Это в 31 раз дешевле Kimi K3 и в 18 раз дешевле Claude Opus 5. Но 30 прогонов подтвердили и оговорку: размах 1,2 и стандартное отклонение 0,3 худшие из всех, идеальны 14 прогонов, худший опустился до 8,8. Каждый пятый-шестой релиз заметно слабее остальных. Для потока это приемлемо, текст всё равно правит редактор, а для разовой публикации это ощутимый риск.
- Для русскоязычных текстов
- YandexGPT rc, и для меня это стало неожиданностью. На 330 прогонах вывод только укрепился: язык 10,00 без разброса на всех 30 прогонах, все факты, ноль выдумки, верность 1,00 и при этом 2,5 секунды. Это в 4 раза быстрее ближайшего конкурента и в 118 раз быстрее самого медленного. Модель работает напрямую, без зарубежного прокси. Единственный замеченный дефект: заголовок на 56 символов вместо 55, для результата это не критично.